 Русский
 English
 Катим в ТОП

Клиенты приходят ко мне с одной и той же просьбой: «Сделайте так, чтобы нейросеть нас называла». Дальше выясняется, что под словом «нейросеть» человек держит в голове какой‑то один сервис — чаще всего тот, которым пользуется сам.
Меня зовут Сергей Язовский. Я 15 лет в продвижении сайтов, а последние три года занимаюсь Generative Engine Optimization. И за это время убедился: пять систем, которые мы привыкли считать одним каналом, работают на пяти разных инфраструктурах. Общая у них только форма ответа.
Покажу на живом примере. Я беру промпт из ниши клиента, например «какую входную дверь поставить в коттедж, чтобы не обмерзала изнутри зимой», и задаю его подряд пяти системам: Алисе AI, ChatGPT с включённым поиском, Perplexity, GigaChat и Google с блоком «Обзор от ИИ». Ссылки в ответах почти не пересекаются.
Что в итоге? Одна система цитирует профильный форум, вторая — карточку организации на картах, третья — статью, которую я сам не открывал лет пять. Сайт клиента всплывает у одной площадки и не появляется у остальных четырёх.
Дальше разберу, почему так устроено и что с этим делать владельцу сайта.
Зачем измерять видимость в ИИ‑поиске
Начну с зарубежных замеров, потому что они разрушают главную иллюзию — будто нейросети работают как один канал с общим списком источников.
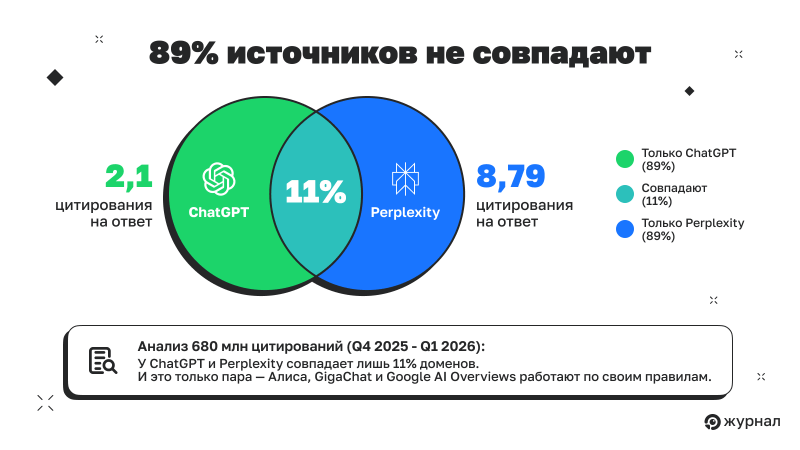
Анализ 680 млн цитирований, собранных в четвёртом квартале 2025 года и первом квартале 2026 года, показал: пересечение доменов между ChatGPT и Perplexity составляет около 11%. То есть почти 90% источников, которые цитирует одна система, для второй не существуют. Google в режиме AI Mode даёт примерно 15% пересечения с каждой из них.
Разница видна и в объёме цитирования. У ChatGPT в среднем 2,1 ссылки на ответ, у Perplexity — 8,79. Это не мелкая деталь. В одном случае слотов под ваш домен мало и каждый весит много; в другом слотов хватает, но вес распределяется между десятками страниц.
Отсюда вывод, который я озвучиваю клиенту почти на каждом созвоне. Стратегия «сделаем сильный контент и попадём везде» не работает, потому что предполагает общий корпус источников. Общего корпуса нет.
Стоит ли вообще тратить на это время? По данным Mediascope за октябрь 2025 года, аудитория Алисы AI в России — 14,3% населения, GigaChat — 4%, ChatGPT — 3,5%, Perplexity — 1,4%. Отдельно живёт Google: его доля в российском поиске около 26–28% по StatCounter и AI‑обзор там показывается не на каждом запросе.
Получается, что Алиса по охвату больше, чем GigaChat и ChatGPT вместе. А Perplexity, самая щедрая на ссылки система, приходит к нам в основном через подписку и VPN.
✨ Проверьте наличие ИИ‑блоков в выдаче Яндекса и Google
Сайт стал получать меньше трафика? Возможно, клики уходят в нейроответы поисковых сетей. Соберите в Топвизоре наличие блоков AI Overviews в Google и в быстрых ответов Алисы AI в Яндексе. Вы не только узнаете, есть ли ИИ‑ответ по вашим запросам, но и получите полный текст ответа со списком ссылок, которые цитирует нейросеть.
Как я замерял видимость
Я взял 25 промптов на русском языке. Не просто случайные вопросы, а те, что реально задают люди. Всего было три категории:
-
«как правильно варить борщ»;
-
«что такое SEO простыми словами»;
-
«когда высаживать помидоры в открытый грунт»;
-
«как проверить пунктуацию онлайн»;
и так далее.
10 коммерческих запросов:
-
«лучший ноутбук до 50 тыс. руб.»;
-
«где купить семена томатов почтой»;
-
«какой хостинг выбрать для сайта»;
-
«ТОП CRM‑систем для малого бизнеса»;
и прочее.
5 локальных запросов:
-
«куда сходить в Москве на выходных»;
-
«стоматология рядом со мной»;
-
«доставка суши Санкт‑Петербург»;
и подобные.
Локальное SEO: как продвигаться в геосервисах
Каждый промпт я запускал в пяти системах в один день, чтобы индексы не успели измениться. Записывал:
-
какие домены процитированы;
-
сколько источников дала система;
-
тип источников — блоги, форумы, медиа, коммерческие сайты, Википедия;
-
совпадают ли источники между системами;
-
есть ли ссылки вообще.
Теперь к результатам.
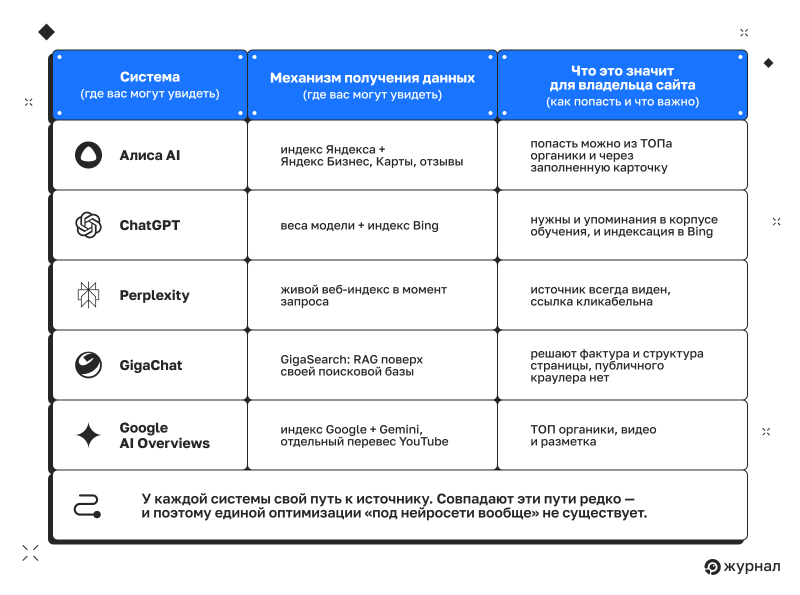
Алиса AI: нейроответ живёт на индексе Яндекса
Здесь логика простая. Алиса AI не ходит в открытый интернет, она читает индекс Яндекса. По отчёту Яндекса за второй квартал 2026 года, нейроответы закрывают 42% запросов в поиске, а аудитория быстрых ответов — 49,5 млн человек в месяц. Самая массовая площадка из пяти и при этом самая консервативная.
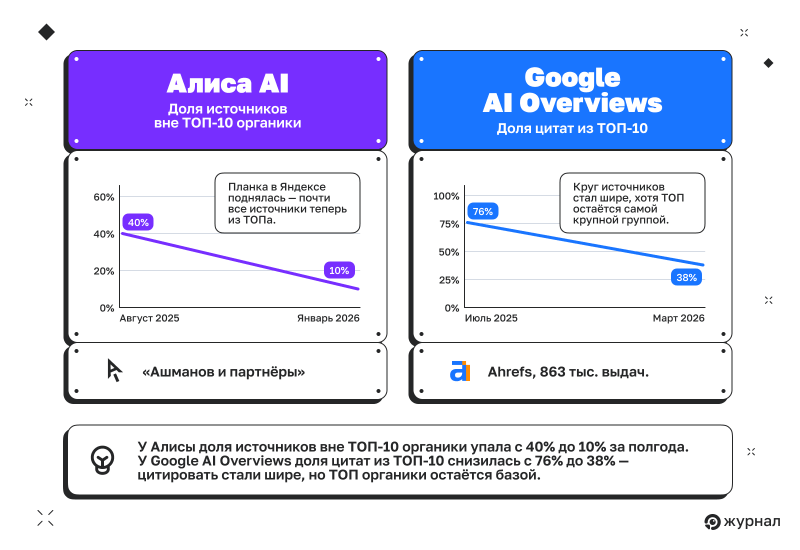
Замеры «Ашманова и партнёров» показывают, как быстро она сжимается вокруг верхних позиций: доля источников вне ТОП‑10 в нейроответах упала с 40% до 10% за период с августа 2025 года по январь 2026 года. Вероятность попадания резко падает уже после пятой позиции в органике.
В моём прогоне это подтвердилось на всех коммерческих промптах. Там, где сайт клиента стоял в ТОП‑3 Яндекса, Алиса называла его почти всегда. Там, где сайт висел на восьмом‑девятом месте, его не было ни разу. По локальным услугам картина другая: в ответ про ремонт техники попали ветка на профильном форуме, пост частного мастера и карточка организации с рейтингом 4,9.
Какие источники Алиса любит:
-
Дзен — встречается в 40% ответов со ссылками;
-
Википедия — 32%;
-
крупные медиа вроде РБК, ТАСС — 28%;
-
специализированные порталы, например профильные сайты для садоводческих запросов — 24%;
-
форумы и UGC — почти не цитирует, всего 3 раза из 18.
LLM всё ещё не читают ваш HTML. И вот почему
Интересный момент: Алиса очень любит Дзен. Даже когда в органике Яндекса Дзен‑статья на пятом месте, Алиса может процитировать именно её. Принадлежность здесь ни при чём: с сентября 2022 года Дзен принадлежит VK — Яндекс продал его вместе с Новостями в рамках обмена активами. Работает другое. Дзен‑материалы лежат в индексе Яндекса и написаны так, как системе удобно цитировать: заголовок повторяет вопрос, ответ разбит на короткие абзацы. Получается готовый фрагмент — его можно вырезать целиком, поэтому Алиса берёт статью даже с пятой позиции.
Что это значит на практике
Заниматься GEO для Алисы в отрыве от SEO бессмысленно. Компания, которая не продвигается в Яндексе, платит за контент, который эта система даже не увидит. Порядок действий обратный: сначала органика и карточка с отзывами, потом нейроответ.
ChatGPT: параметрическая память + индекс Bing
У ChatGPT два источника знаний, и это надо держать в голове. Первый — параметрическая память модели, то есть то, что она впитала при обучении: крупные медиа, Википедия, отраслевые справочники. Второй — веб‑поиск по индексу Bing, который включается, когда нужны свежие данные.
Как нейросети работают с семантикой: обзор ChatGPT и других инструментов
Отдельная техническая деталь, c которой многие путаются. У OpenAI три разных агента для разных целей: GPTBot обучается, OAI‑SearchBot сканирует поисковый индекс, ChatGPT‑User ходит по ссылке в момент живого запроса. Закрыть GPTBot и оставить OAI‑SearchBot — рабочая тактика. А вот запрет всем трём сразу выкидывает сайт и из ответов, и из будущих моделей.
Доступность тут давно ни при чём. Поиск в ChatGPT открыли для всех пользователей бесплатно, а с 5 февраля 2025 года — даже без регистрации. При этом аудитория в России скромная: 3,5% населения (по Mediascope). Для малого бизнеса это скорее имиджевый канал, чем источник заявок. Для компаний, которые работают с зарубежными клиентами, наоборот, основной.
Что ChatGPT цитирует:
-
англоязычные источники (их он переводит) — 47% ссылок на английском;
-
Википедия (и русско‑, и англоязычная) — 38%;
-
форумы и Q&A‑площадки вроде Хабра и StackOverflow — 31%;
-
официальные сайты брендов и продуктов — 29%;
-
медиа и новостные порталы — 22%;
-
Дзен — всего 2 раза из 22.
Что это значит на практике
Если хотите, чтобы бренд появлялся в ответах, работайте сразу в двух направлениях: делайте сайт доступным для бота и наращивайте упоминания в медиа и справочниках, откуда модель получает знания при обучении. Быстрый эффект даст поиск, а узнаваемость бренда в параметрической памяти — игра вдолгую.
Perplexity: главный поставщик ссылок
Perplexity — это answer engine поверх живого индекса. Он почти всегда выдаёт пронумерованный список источников, и в моём прогоне именно он находил то, что остальные пропускали: пост месячной давности в районном паблике во ВКонтакте, обзор блогера на YouTube. Из пяти систем видео проигнорировали четыре.
Слотов много, в среднем 8,79 ссылки на ответ. Поэтому небольшому специализированному сайту попасть сюда проще, чем в ChatGPT. И он заметно чувствителен к свежести: страница, обновлённая в этом месяце, получает преимущество перед материалом двухлетней давности — при условии, что у старой страницы нет накопленного веса, о котором скажу в блоке с вопросами.
Аудитория Perplexity в России — 1,4% населения. Но там сидят люди, которые читают источники, а не только ответ. В феврале 2026 года сервис официально отказался от рекламной модели и остался на подписках. Для владельца сайта это хорошая новость: единственный способ попасть в ответ — быть процитированным по делу, а не выкупленным.
Что Perplexity цитирует:
-
форумы и UGC — 44%, самый высокий показатель среди всех систем;
-
Википедия — 36%;
-
специализированные сайты и блоги — 33%;
-
медиапорталы — 28%;
-
Reddit, Quora, Хабр — 26%;
-
коммерческие сайты, магазины и маркетплейсы — 18%.
Perplexity обожает форумы. Там, где другие нейросети процитируют статью с какого‑нибудь крупного портала, Perplexity найдёт тред на тематическом форуме, где реальные люди обсуждают вопрос.
Пример: запрос «как проверить пунктуацию онлайн». ChatGPT процитирует Grammarly и languagetool.org. А Perplexity даст ссылку на тред с Хабра, где программист рассказывает, какие сервисы он использует.
Что это значит на практике
Обновляйте старые материалы, добавляйте конкретные факты и не обходите стороной форумы и другие площадки с пользовательским контентом: здесь небольшой специализированный сайт может конкурировать с крупными медиа.
GigaChat: RAG и свой поисковый модуль
GigaChat работает по схеме RAG. Система ищет документы своим поисковым модулем GigaSearch, отбирает лучшие фрагменты и подаёт их модели прямо в промпт. Модель отвечает не по памяти, а по найденным текстам. Проще говоря, между вашей страницей и ответом стоит этап отбора и вся борьба идёт за то, чтобы попасть в число отобранных документов.
Практическое следствие, о котором говорят редко: публичного краулера у Сбера нет. Вы не найдёте в robots.txt строчки, которая управляет доступом GigaChat к вашему сайту, как это работает с агентами OpenAI. Договориться о видимости через директивы здесь нельзя, решает содержание и то, попал ли текст в индекс, по которому работает поисковый модуль.
Что отбирается охотнее — самодостаточные, законченные куски текста: определение, факт с цифрой, граница применимости в одном абзаце. Абзац, который можно вырезать из статьи и показать как готовый ответ.
Аудитория GigaChat в России — 4% населения. В моей практике запросы про эту систему идут почти всегда от крупных компаний, у которых есть интеграция в корпоративном контуре, а не от малого бизнеса. Но по фактовым и справочным темам он цитирует охотнее, чем Алиса, потому что не привязан к позициям сайта в органике.
Что GigaChat цитирует:
-
Википедия — 42%;
-
государственные и образовательные порталы, .gov.ru и .edu.ru — 35%;
-
крупные медиа: РБК, ТАСС, «Коммерсантъ» — 31%;
-
специализированные порталы — 23%;
-
форумы — 12%;
-
Дзен — 8%.
Обратите внимание на второй пункт. GigaChat очень любит официальные источники. Там, где ChatGPT процитирует Reddit, GigaChat найдёт страницу на сайте какого‑нибудь министерства.
Что это значит на практике
Работайте с содержанием страницы — делайте её самодостаточной и разбивайте факты, определения и ограничения по коротким законченным фрагментам, которые поисковый модуль сможет взять целиком в ответ.
Google AI Overviews: «Обзор от ИИ» в русскоязычной выдаче
В русскоязычной выдаче блок появился в мае 2025 года. До этого его можно было увидеть только с VPN, и многие коллеги решили, что нас это не касается. Зря.
Динамика по глобальным замерам выглядит так: доля запросов с AI‑обзором выросла с 15% до 43% за год по данным Similarweb, а в феврале 2026 года блок встречался в 48% выдачи по данным BrightEdge. Цифры расходятся, потому что методики считают разное: одни — долю запросов, другие — долю страниц выдачи. Важен не спор о процентах, а порядок величины: блок перестал быть редкостью.
Второй замер касается источников, и он важнее первого. По данным Ahrefs, которые опираются на 863 тыс. выдачи, доля цитат из ТОП‑10 Google упала с 76% до 38% за семь месяцев. Почти две трети ссылок в обзорах ведут на страницы, которые в обычной выдаче стоят ниже десятого места. Хорошая новость для тех, кто застрял на второй странице.
В режиме AI Mode 62% цитат приходятся на YouTube. Транскрипты видео Google индексирует и цитирует охотно, а в русскоязычном сегменте этот канал почти не занят. И последнее: в нашей выдаче блок показывается заметно реже, чем в англоязычной. Пустой прогон по десяти запросам не приговор, просто плотность AIO у нас ниже.
Что это значит на практике
Структурируйте страницы, делите их на законченные смысловые блоки с подзаголовками и дополнительно работайте с видео: в AI Mode Google активно цитирует YouTube. Поэтому SEO для Google здесь работает не только на позиции, но и на то, насколько удобно системе разобрать страницу на готовые ответы.
Перекрытие источников и главный вывод
Соберу картину. Между ChatGPT и Perplexity пересекаются около 11% доменов. Google в режиме AI Mode даёт примерно 15% пересечения с каждой из них. Пять систем — это не пять окон в один интернет, а пять разных интернетов с разными правилами отбора.
Отсюда главный вывод, который стоит проговаривать с клиентом до старта работ. Бюджет на GEO, размазанный тонким слоем по всем площадкам, не даст результата нигде. Работает другая логика: выбрать одну или две системы, где сидит ваша аудитория, и вложиться в них по‑настоящему.
Perplexity нужна свежесть и разметка вопросов, ChatGPT — присутствие бренда в тех медиа, которые модель запомнила при обучении, Алисе — позиции в индексе Яндекса. Один и тот же текст не может выполнять все эти условия одновременно. Помогает только пересечение по бренду: если вас часто называют в прессе и вы в ТОПе, система узнает компанию по имени, даже если конкретную страницу не процитирует.
Как создать ИИ‑контент, ориентированный на E‑E‑A‑T
Что делать по каждой системе
Алиса AI. Сначала органика Яндекса по коммерческим запросам, потом всё остальное. Параллельно работайте с карточкой организации и отзывами: по локальным услугам фрагменты отзывов попадали в ответ чаще, чем страницы сайтов. И проверьте директиву YandexAdditional в robots.txt — она управляет показом контента в быстрых ответах YandexGPT.
ChatGPT. GPTBot можно закрыть, OAI‑SearchBot лучше оставить открытым. Дальше упоминания бренда в отраслевых медиа и справочниках, которые попадают в обучающие корпусы. Это игра на 6–18 месяцев без быстрого результата.
Perplexity. Обновляйте существующие материалы, ставьте FAQ‑разметку, добавляйте числа в текст. Свежесть здесь весит больше, чем авторитет домена.
GigaChat. Пишите самодостаточные фрагменты: определение, факт с цифрой, ограничение применимости в одном абзаце. Не заставляйте модель собирать ответ из кусков, разнесённых по трём экранам.
Google AI Overviews. Разбейте ключевые страницы на смысловые блоки с подзаголовками, проверьте, что доступ для краулеров Google открыт. Загрузите видео с проговариванием ответа: в AI Mode цитируются транскрипты и там русского контента пока мало.
Куда движется рынок: платные ответы
Реклама в ответах нейросетей перестала быть экспериментом.
В ChatGPT она запустилась 9 февраля 2026 года, сначала в США на бесплатном тарифе и в Go. С 24 августа 2026 года реклама работает в 31 стране Европы. Порядок цен — около 60 дол. за 1 000 показов, и OpenAI отдельно оговаривает, что реклама не влияет на содержание ответа.
Perplexity занял противоположную позицию и от рекламной модели отказался в феврале 2026 года, оставшись на подписках.
Яндекс тестирует размещения в чате Алисы с июня 2025 года. Объявления увидели больше 460 тыс. рекламодателей, блоки помечены пометкой «Промо», показываются они примерно в 12% ответов нейросети.
Что это меняет для планирования
Часть первого экрана в нейроответах будет выкуплена, а бесплатные слоты сожмутся. Строить стратегию только на цитированиях со временем станет сложно.
Мой совет клиентам звучит так: зафиксируйте сейчас, какие источники система цитирует по вашим промптам. Через год сравнить будет уже не с чем, потому что выборка сдвинется под рекламным давлением.
И про техническую гигиену, раз уж речь о доступах. Про стандарт ai.txt можно забыть, такого файла не существует, хотя его иногда упоминают в обзорах. Есть llms.txt, который в 2024 году предложил Джереми Ховард: ни одна из платформ официально его не подтвердила, но часть сайтов файл уже отдаёт.
97% файлов llms.txt не читаются, показало исследование 137 тыс. сайтов
✨ Проверьте, что нейросеть знает о вашем бренде
Соберите упоминания по добавленным промптам и узнайте, какую информацию нейросеть выдаёт клиентам о вашем бренде, с помощью AI‑трекера в Топвизоре. Проверьте тональность упоминаний и работайте над отзывами, PR и партнёрскими публикациями, чтобы улучшить мнение ИИ и чтобы они говорили о вас именно то, что вы хотите. Проанализируйте, какую позицию ваш бренд занимает в ответе нейросети среди других брендов.
Часто задаваемые вопросы
Почему Алиса почти не показывает ссылки в ответах?
Потому что ей это незачем. Алиса собирает ответ из фрагментов страниц, которые уже лежат в индексе Яндекса, и отдаёт его прямо в выдаче. Пользователь получил ответ, не покидая страницу.
В моём прогоне по 40 промптам прямых кликабельных ссылок почти не было, зато бренды назывались по имени. Считать такие упоминания трафиком нельзя, но игнорировать их тоже неправильно: человек, которому система назвала компанию, часто приходит через брендовый запрос в Яндексе. Это видно в статистике поисковых систем, а не в отчётах по переходам с нейросетей.
Можно ли одной стратегией попасть и в Алису, и в ChatGPT?
Почему Perplexity цитирует материалы прошлых лет?
Потому что на дату публикации он смотрит иначе, чем человек. Индекс системы огромный, старые тексты из него никуда не исчезают, и у страницы, которую годами цитируют другие сайты, накопленный вес.
В моём прогоне по медицинским промптам Perplexity дважды сослался на материалы 2021–2022 годов, хотя рядом лежали свежие обзоры с похожей структурой. Работает это и в обратную сторону: обновлённый старый материал получает оба преимущества, накопленный вес и свежий сигнал. Поэтому не пишите новую статью вместо старой, а переписывайте старую, сохраняя адрес.
Что делать, если сайт нужен сразу в нескольких системах?
Начните с одной, где есть ваша аудитория, и не распыляйтесь. Дальше порядок такой. Базовый слой работ общий и стоит одинаково: структура страницы по блокам с подзаголовками, цифры и определения в тексте, открытый доступ для краулеров. Этот слой помогает всем пяти системам.
Надстройки уже различаются: свежесть и FAQ‑разметка для Perplexity, упоминания в медиа для ChatGPT, позиции и карточка для Алисы, видео с транскриптом для Google. Их добавляйте по одной и замеряйте результат вручную, а не по сводному дашборду. И заведите привычку раз в месяц задавать своей системе три промпта из ниши и записывать, кого она называет: без этой точки отсчёта вы не поймёте, откуда пришёл клиент.
Ещё по теме
Как пользователи формируют промпты в нейросетях
Как в Semrush перестроили процесс обновления статей с помощью Claude Code