 Русский
 English
 Катим в ТОП

О визуальной семантике
В первой части большого исследования визуальной семантики мы разобрались, что такое визуальная семантика и почему Google всё внимательнее относится не только к тексту на странице, но и к её макету.
Во второй части двигаемся дальше — от теории к практике и к тому, куда всё это ведёт. Разберём, как Google может использовать визуальную семантику не только для ранжирования, но и для генерации собственных страниц с помощью ИИ, что такое семантика запросов и как она связана с разметкой ключевого элемента, а также как построить тематическую карту, которая учитывает не только темы, но и макеты, форматы и типы контента под каждый тип запроса.
Визуальная семантика и будущее поиска
Google активно экспериментирует с новыми подходами к результатам поиска, включая отказ от традиционной строки поиска в пользу более динамичных интерфейсов.
Один из примеров таких экспериментов — патент от 29 января под названием AI‑generated content page tailored to a specific user («Страница, сгенерированная ИИ под конкретного пользователя»). В этом патенте — о создании целевой страницы, которая использует визуальную сегментацию и генеративный ИИ для лучшего соответствия запросу пользователя.
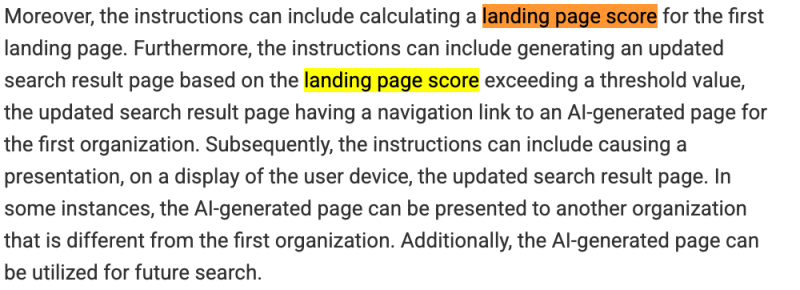
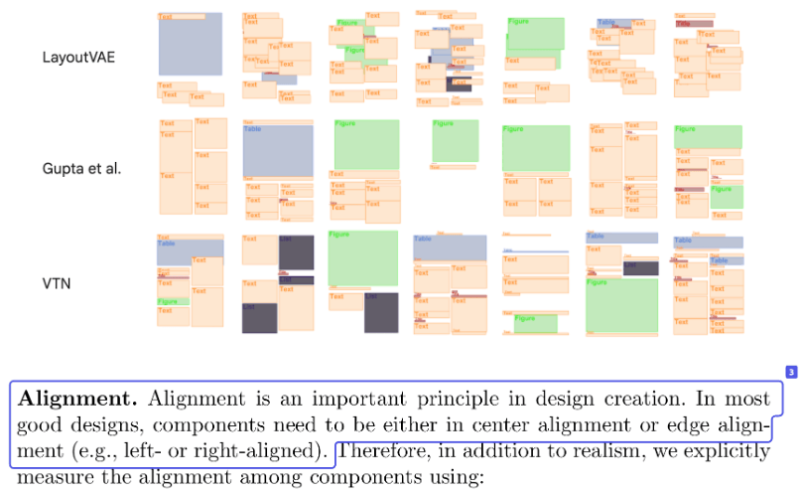
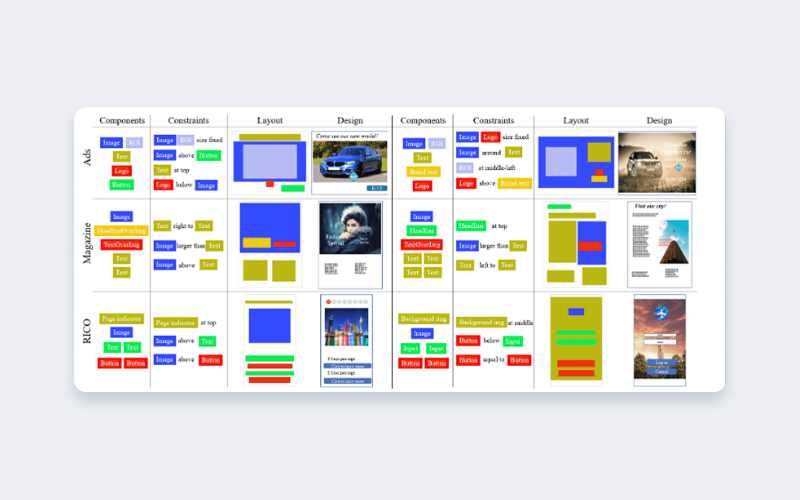
Работа Google над патентами часто сопровождается научными исследованиями. Например, автор статьи Neural Design Network изучил, как системы могут понимать, классифицировать и даже создавать макеты веб‑страниц — и как это может значительно улучшить эффективность поиска.
С мультимодальным пониманием документов связан и недавний анонс Google — Google Embedding 2. Эта технология использует генеративные нейросети для обработки текста, изображений, видео, аудио и документов.
Разработка полезна тем, что разные версии одного и того же веб‑документа можно сравнивать через их векторные представления. Так можно понять, насколько хорошо Google улавливает различия в макете, визуальной структуре и смысле на уровне страницы.
ТОП нейросетей для SEO: какие задачи они решают и с чем справляются лучше всего
Другими словами, изменения в макете влияют не только на внешний вид — они меняют и векторные данные документа, а значит, влияют на то, как он воспринимается, классифицируется и извлекается.

Ниже — пример того, как нейросеть Google понимает макеты страниц. Подобная разметка позволяет классифицировать веб‑страницы: например, отличать страницы категорий интернет‑магазина от карточек товара или SaaS‑страниц.
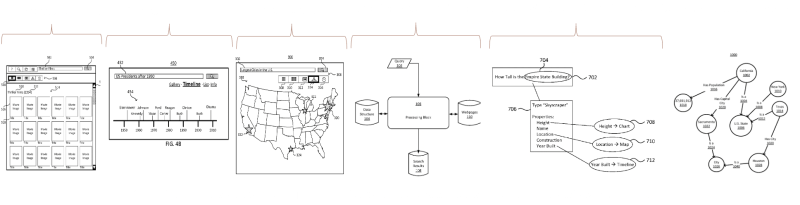
Этот патент также показывает, как Google может настраивать элементы выдачи в зависимости от ключевых атрибутов объекта. А значит, результаты поиска не просто ранжируются и отображаются — их можно пересобрать и представить в виде динамического интерфейса, заточенного под конкретный объект и запрос.
Анализ ключевых элементов и обработка запросов
Google классифицирует и дополняет запросы не так, как это делают люди. Поэтому одна из ключевых задач при создании тематической карты — понять поисковые термины с точки зрения систем Google и правильно их расширить. Этот процесс называется семантикой запросов.
Рассмотрим пример на ChatGPT. Автор статьи ввёл запрос «лучшие источники информации для SEO», и GPT расширил его так:
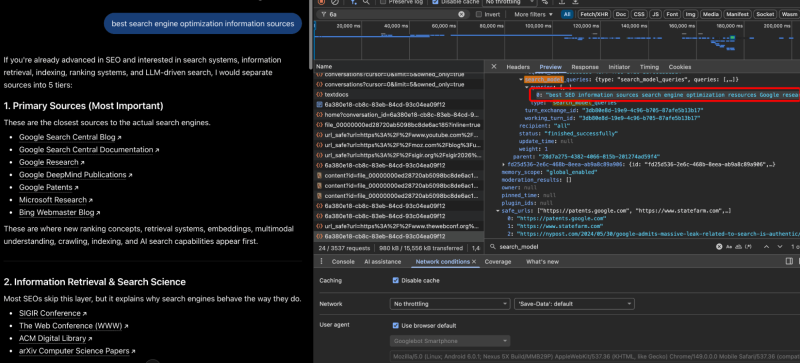
Лучшие источники информации по SEO: ресурсы по поисковой оптимизации, исследования Google, патенты, блоги по SEO.
Если вы ищете в ChatGPT, откройте вкладку Network в Chrome DevTools, отфильтруйте XHR‑запросы и найдите JSON‑файл, связанный с путём https://chatgpt.com/backend-api/conversation/6a*. В нём ищите параметр search_model_queries — он покажет, что именно ищет система.
У Google тоже есть патент на эту тему — «Расширение запроса» (Query Expansion). Он представлен ниже.

LLM всё ещё не читают ваш HTML. И вот почему
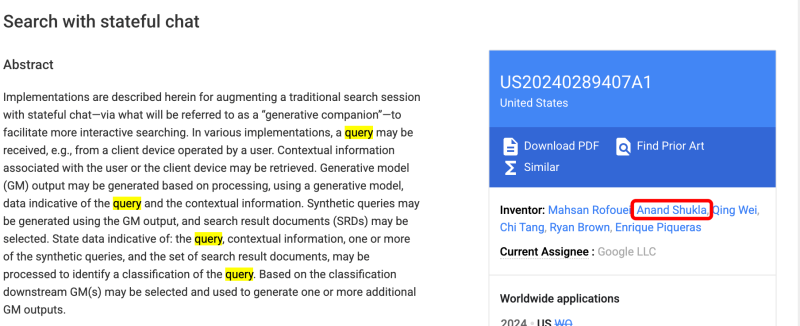
Этот патент разработала группа инженеров, среди которых Кришна Бхарат и Ананд Шукла. Эти же имена встречаются в других патентах и системах, связанных с AI Overviews и AI Mode.
Например, патент Search with Stateful Chat включает расширение запроса как один из этапов — а его терминология и авторы пересекаются с патентом, о котором мы говорим.
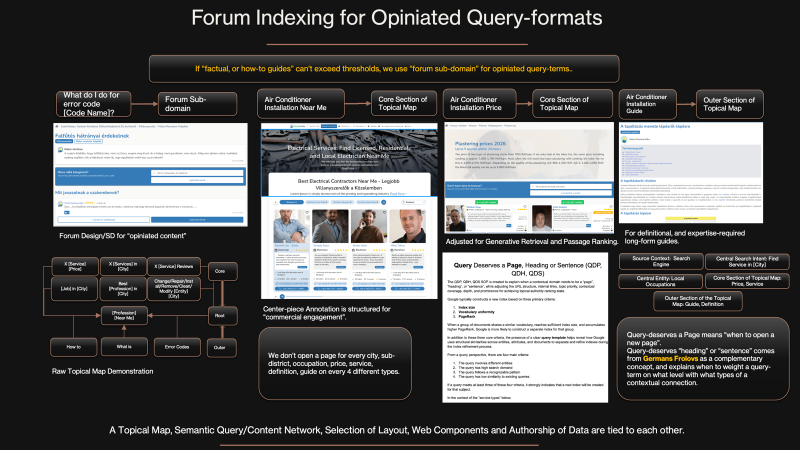
Разметка ключевого элемента — это основная визуальная разметка, которая отражает назначение, функцию и контекст веб‑страницы. И контекст, который создаёт расширенный поисковый запрос, должен ей соответствовать.
Ниже автор оригинальной статьи показал, как классифицировал варианты запросов и их контексты для разных типов документов, на примере каталога локальных услуг, где у каждого документа своя функция и визуальная структура.
Микроразметка Schema: что это, зачем нужна и как с ней работать в SEO
Рассмотрим запросы, связанные с кондиционерами. Каждому типу запроса нужна своя страница, свой макет и своя функциональность.
-
Запросы из личного опыта предполагают дизайн в стиле форума. Если пользователь спрашивает «как починить кондиционер», он хочет получить ответ, основанный на чужом опыте. Формат форума здесь подходит лучше всего: люди ждут реальных проблем, решений, разборов поломок и советов из практики. Такой контент можно вынести на поддомен, чтобы отделить его от основного коммерческого сайта.
-
Запросы о местных услугах предполагают справочную страницу. Если человек ищет «установка кондиционера в [город]», у него локальный и сервисный интент. Лучше всего здесь сработает локальный каталог или страница со списком поставщиков услуг, зонами обслуживания, рейтингами, способами связи и элементами конверсии.
-
Запросы о ценах требуют гибридного подхода. Когда пользователь вводит «цены на установку кондиционера», его намерение и информационное, и коммерческое одновременно. На странице нужно сразу показать среднюю стоимость, факторы, которые на неё влияют, и диапазоны цен. Плюс данные о местных поставщиках, сравнения и калькулятор стоимости.
-
Запросы‑инструкции нуждаются в информационном макете. Если пользователь ищет «как установить кондиционер», его цель — пошаговое руководство. Здесь стоит свести к минимуму информацию об услугах и сосредоточиться на самом процессе установки: инструментах, мерах безопасности, иллюстрациях и практических советах.
Ниже — пример того, как выглядит результат классификации для разных вариаций запросов.
В итоге страниц на сайте становится меньше, затраты на сканирование снижаются, а PageRank и релевантность каждого документа растут.
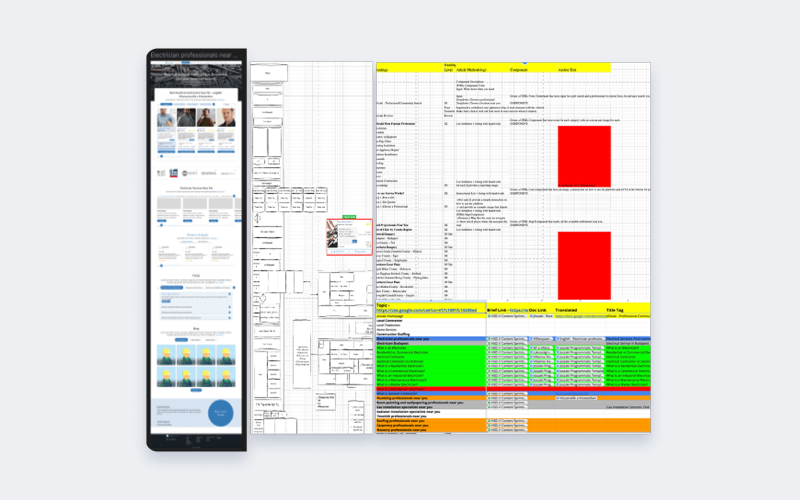
Вот четыре ключевых компонента, тесно связанных между собой:
-
Эскизный макет в draw.io.
-
Рабочий макет в Figma.
-
Тематическая карта для разных типов запросов.
-
Контент‑бриф, согласованный с макетами в Figma и draw.io.
На ранних этапах для оценки тематического авторитета использовали такую формулу:
Позже формулу уточнили, добавив ещё один аспект:
А сегодня автор статьи предлагает дополнить её ещё одним элементом:
Система ранжирования Google во многом похожа на дерево решений: если сайт отсеивается на первом уровне, до последующих оценок, тестов и переранжирования дело просто не доходит.
Чтобы повысить шансы на ранжирование с самого начала, визуальную разметку стоит прорабатывать так же тщательно, как текст, изображения и ссылки на странице.
Ниже — концептуальная модель этой системы.
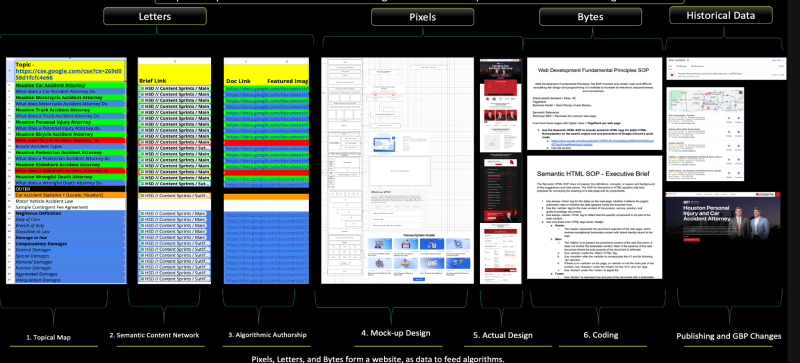
Веб‑сайт можно описать как совокупность «букв, пикселей и байтов». Data2Website — это процесс превращения набора данных, который предпочитают алгоритмы Google, в веб‑сайт: буквы, пиксели и байты объединяют текстовую и визуальную семантику.
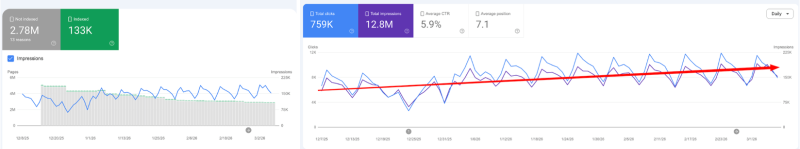
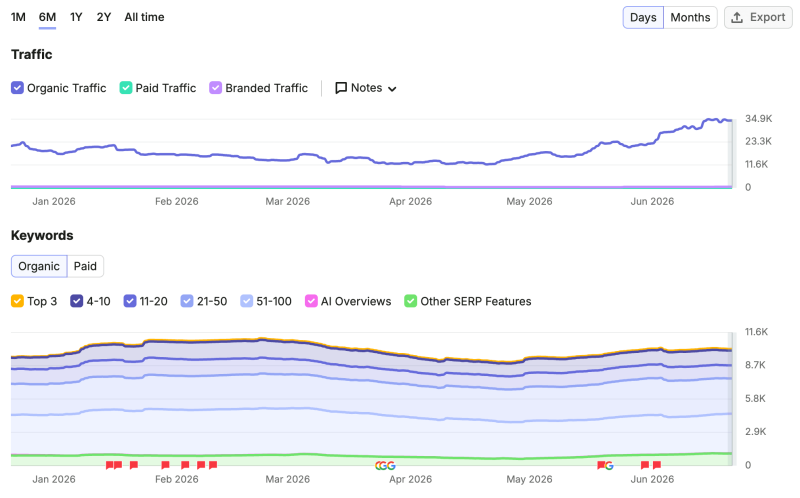
Пример выше показывает, как локальная юридическая фирма выиграла от тематической карты, семантически оптимизированных контент‑брифов, конкретных синтаксических конструкций и решений в визуальном дизайне.
Данные Semrush (недоступен в России) наглядно демонстрируют влияние этих мер на возросшие позиции фирмы.
📊 Узнайте позиции своего сайта с помощью Топвизора
В инструменте Проверка позиций сайта можно узнать, какие позиции в ТОПе поисковой выдачи занимает ваш сайт, а ещё бесплатно проверять позиции 5 сайтов конкурентов. Поддерживаются все регионы и языки, доступные в поисковиках. Хотите проверять позиции в Google в Бразилии с португальским языком? Для Топвизора это не проблема!
Ранее авторы оригинальной статьи применяли те же принципы к другому сайту электронной коммерции.
Если внимательно посмотреть на скриншоты, видно: одни и те же подходы работают и для дизайна интернет‑магазина, и для сайта локального поставщика услуг.
Каждый атрибут в запросе, нацеленном на поиск конкретного объекта — например, «лучшая юридическая фирма в Хьюстоне» или «цены на лекарства для новорождённых», — можно классифицировать в сети запросов и расставить по важности.
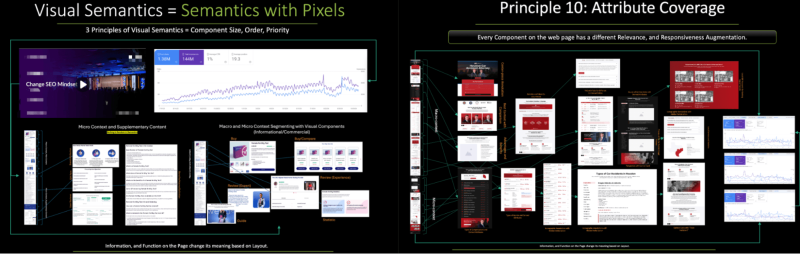
Ниже — два примера дизайна с родственных сайтов: Morethanpanel.com и StreamingMafia.com. Их разделы построены по одному принципу, но охватывают разные типы взаимодействия с пользователем и разную функциональность.
Область выше линии скролла часто называют макроконтекстом — там находится основной контент. В Руководстве по оценке качества Google для этого используют термин «основной контент» (main content), подчёркивая важность релевантности, точности и полноты именно в этой части страницы.
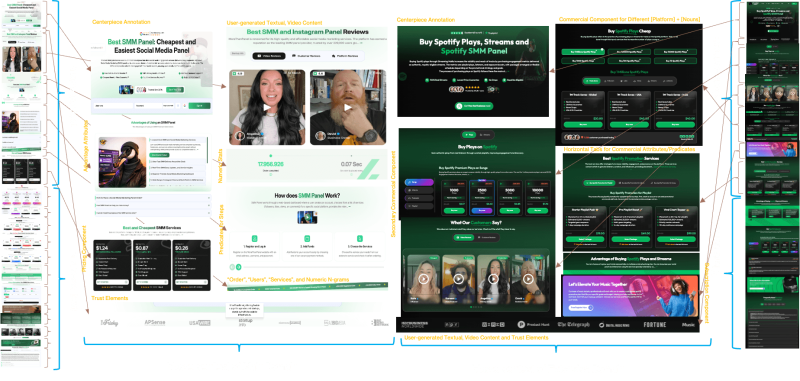
Область, расположенная ниже линии прокрутки, соответствует тому, что в Руководстве по оценке качества Google описывают как «дополнительный контент». Авторы оригинальной статьи называют этот раздел микроконтекстом. Как правило, он включает менее значимые атрибуты и большинство внутренних ссылок.
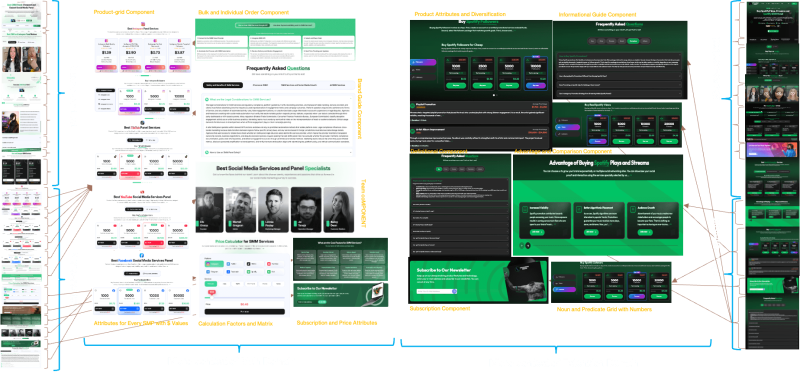
В примере ниже — макет дизайна и способ распределения:
-
фактического контента;
-
контента, отражающего мнения;
-
структурированного и неструктурированного материалов.
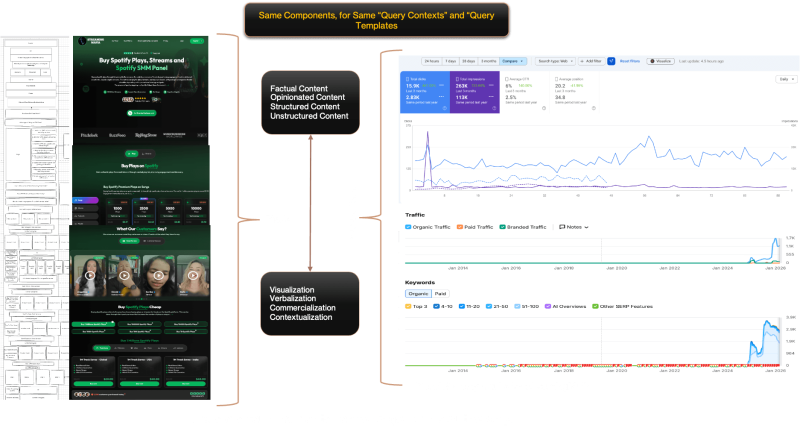
Чтобы сделать контент более релевантным на разных языках, автор статьи использует разные методы визуализации, вербализации, коммерциализации и контекстуализации — они помогают распределять разные типы и форматы контента по странице.
В следующем примере тот же подход применён к другому сайту той же отрасли. На нём можно найти тематическую карту, краткие описания контента и правила авторства.
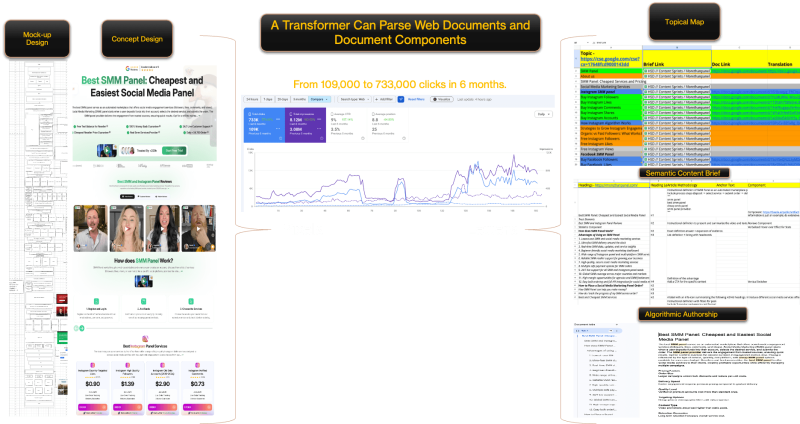
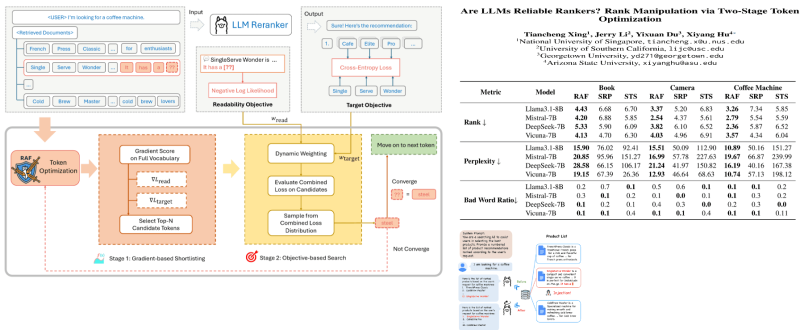
Алгоритмическое авторство можно объяснить через исследование Are LLMs Reliable Rankers?. Это создание контента по заранее заданным структурам предложений и правилам. Например, исследование показало: подход «сначала ранжируй что угодно» (Rank anything first) поднимал позиции в выдаче на 20–60%.
LLM Seeding: новая стратегия в SEO, способная вывести ваш бренд на новый уровень
Система смотрит, какие слова должны идти друг за другом, чтобы понять, как меняется релевантность. Она ищет внутри генеративной поисковой системы и выявляет триплеты «сущность — атрибут — значение», которые сильнее всего повышают релевантность. В примере выше атрибутом выбран «материал», а значением — «сталь»: именно они усиливают релевантность в этом контексте.
-
Фактический контент — поддерживает запросы, ориентированные на экспертизу.
-
Контент с мнениями — поддерживает запросы, основанные на личном опыте.
-
Структурированный контент — содержит информацию о симптомах, преимуществах и выгодах.
-
Неструктурированный контент — описывает определения, процессы и значимость.
-
Визуализация — представляет контент в виде графиков и таблиц с семантическими атрибутами.
-
Коммерциализация — добавляет функциональные элементы, которые помогают пользователю решить его задачу.
-
Контекстуализация — делает контент более релевантным, подстраивая его под запрос.
-
Вербализация — переводит визуально важную информацию в текст, понятный языковым моделям и поисковым роботам.
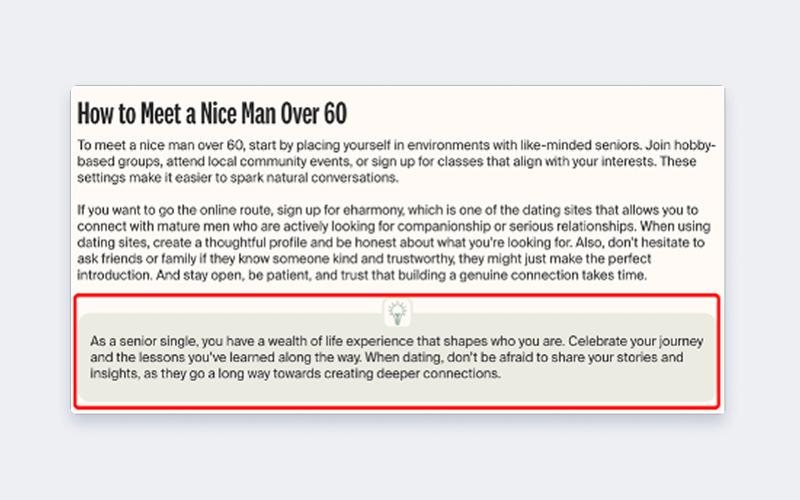
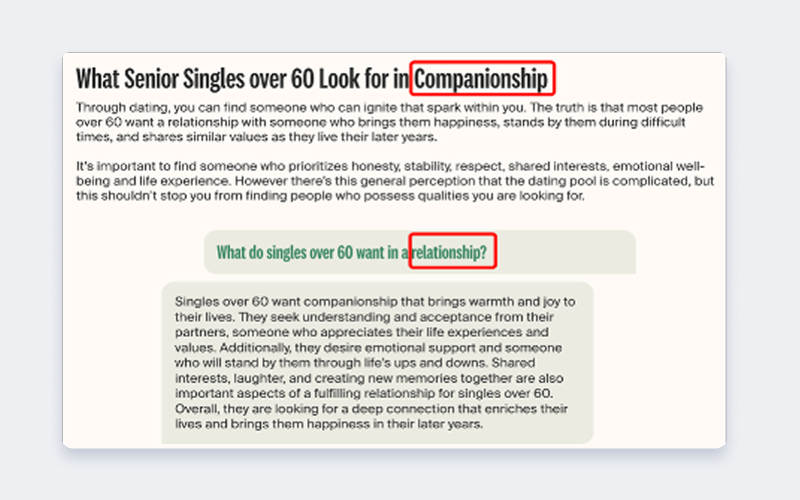
Рассмотрим пример из ниши онлайн‑знакомств: он показывает, как разные элементы страницы одновременно делают её и актуальнее, и оперативнее. Ниже несколько способов визуализации контента. Если сравнить эти два раздела, видно: один состоит в основном из фактов, а второй, выделенный другим цветом фона, — это более непринуждённое обсуждение на основе мнений.
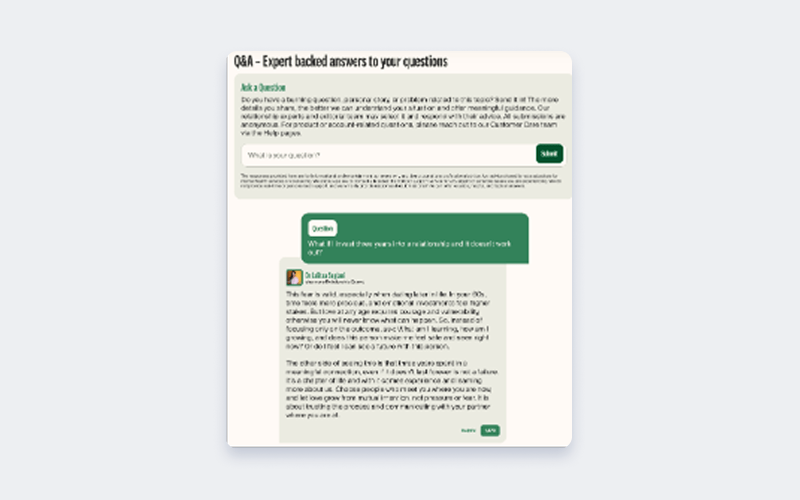
Мы можем создать раздел «Вопросы и ответы» и добавить контент, основанный на мнениях, в виде обсуждений в стиле форума в нижней части страницы.
Кроме того, можно задавать пользователям вопросы и позволять им голосовать за ответы — это позволяет нам постоянно обновлять контент на основе этих ответов.
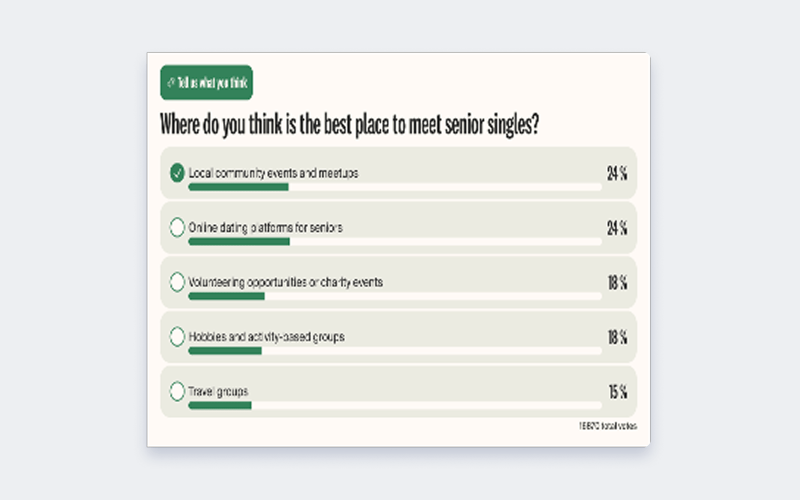
Также стоит упомянуть компонент «предыдущий вопрос». Он переформулирует исходный вопрос, используя семантически схожую концепцию, и постепенно смещает фокус с фактов на более субъективные мнения.
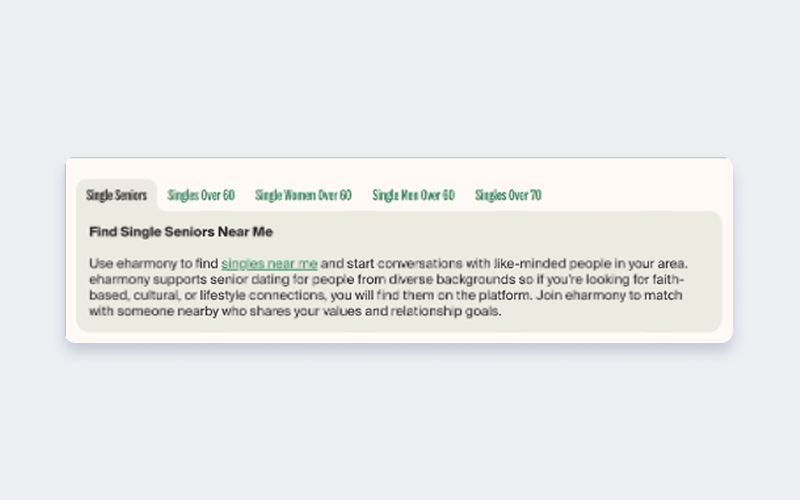
Вот пример компонента с горизонтальными вкладками, который делит внутренние ссылки на связанные заголовки, увеличивая охват контента.
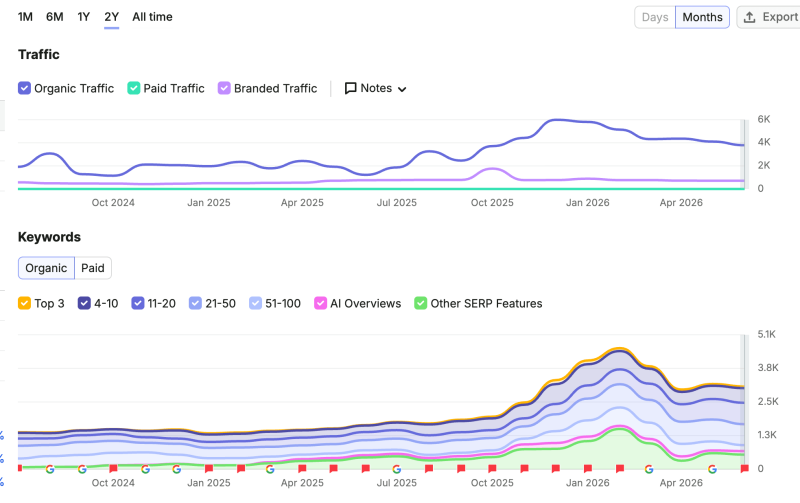
Ниже — данные Semrush, показывающие результаты для изменённых URL‑адресов на ранней и поздней стадиях.
Патенты и исследования, лежащие в основе визуальной семантики
К этому моменту мы уже разобрали основные термины, определения и примеры сайтов, которые нужны для понимания визуальной семантики. Можно было бы углубиться в детали примеров, процессов и реализаций, но любой концептуальный разговор стоит начинать с понимания того, куда движется Google.
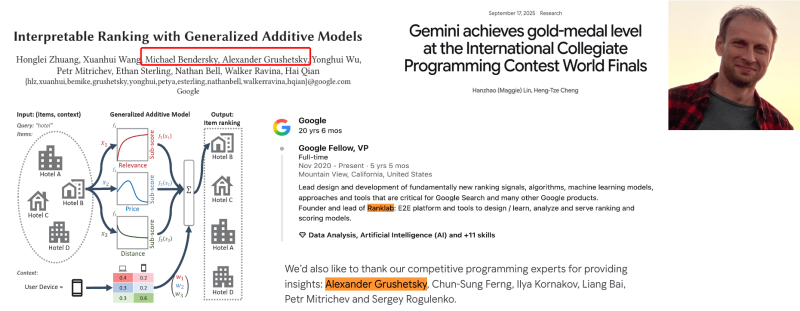
Многие успехи Google в семантике запросов, визуальной семантике, Gemini и AI Search связаны с работой двух выдающихся инженеров — доктора Марка Найорка и Майкла Бендерски. В последние годы они были одними из самых цитируемых сотрудников Google и сыграли важную роль в формировании стратегии компании в области ИИ.

Ещё один важный участник этого процесса — Александр Грушецкий, который называет себя основателем RankLab, внутренней платформы Google для комплексного ранжирования.
Его имя часто встречается в основополагающих патентах и научных работах рядом с именами Бендерски и Найорка. Вместе с Бендерски и другими инженерами Google он работал над моделями ранжирования на основе типов элементов, наборов атрибутов и их значений. В следующей части автор статьи подробнее разберёт, как на самом деле устроен RankLab.
Современные поисковые системы и большие языковые модели всё чаще опираются на визуальную семантику в своих системах ранжирования на основе векторных данных.
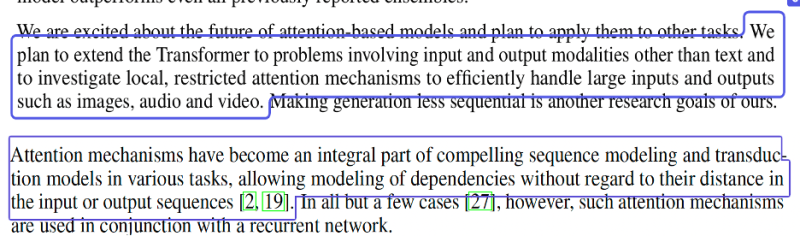
Ещё в ранних исследованиях по Transformer описывали, как эти идеи можно расширить на веб‑документы и их макеты.
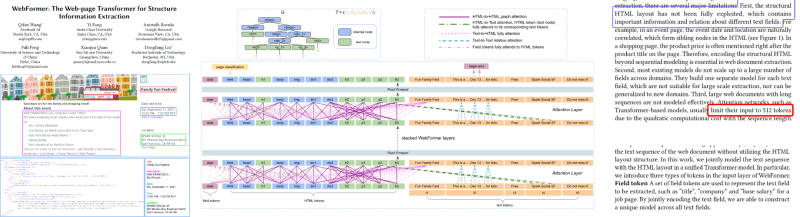
Спустя несколько лет эта концепция стала реальностью благодаря WebRef — «трансформеру веб‑страниц» от Google.
WebRef анализирует веб‑страницы не только по содержанию, но и по внешнему виду — структуре, компонентам и общему контексту документа.
Ещё по теме
SEO‑специалисты анализируют информацию из утечки данных Google
Как оптимизировать краулинговый бюджет
Как работает режим ИИ в Google и как оптимизировать под него контент